Insights
— Plattform
Metadaten schreibt, wer sie am wenigsten braucht
Wer ein Asset hochlädt, weiss alles darüber. Wo es entstand, wer darauf ist, wofür es war. Diese Person wird nie danach suchen, denn sie weiss ohnehin, wo es liegt. Wer suchen wird, sitzt anderswo, Monate später, und weiss nichts davon. Jede Tagging-Richtlinie versucht, diese beiden zu verbinden, und die meisten scheitern an derselben Stelle.
Mathias Buschor
Mitgründer bei moodcase
•
4
min Lesedauer

Die übliche Empfehlung kommt als Richtlinienfrage. Festlegen, wer taggt. Festlegen, wann. Aufschreiben. Beim Upload durchsetzen.
Jede Fassung dieser Empfehlung nimmt dasselbe an: dass die richtigen Tags existieren und jemand versäumt, sie hinzuschreiben.
Das ist eine vernünftige Antwort auf ein anderes Problem. Sie behandelt Tagging als Disziplinfrage, als würde die Arbeit nicht getan. Die Arbeit wird getan. Sie wird von jemandem getan, der nicht wissen kann, was gefragt werden wird.
Wissen und Bedarf liegen an verschiedenen Orten
Beim Upload hält eine Person den vollen Kontext. Das Shooting, das Briefing, den Grund für die Wahl eines Bildes. Sie taggt, was relevant scheint, also was ihr in dieser Woche für diese Kampagne auffällt.
Neun Monate später braucht jemand anderes ein Bild. Diese Person sucht nicht die Kampagne. Sie sucht etwas mit herbstlicher Farbigkeit oder eine Person über sechzig oder einen Ort, der nordeuropäisch wirkt. Nichts davon war beim Upload relevant, also wurde nichts davon notiert.
Das Versagen ist keine Faulheit. Relevanz bei der Aufnahme und Relevanz beim Wiederfinden sind zwei verschiedene Dinge. Nur eine davon ist bekannt, während getaggt wird.
Was eine Richtlinie tatsächlich erzeugt
Richtlinien schliessen die Lücke, indem sie mehr verlangen. Mehr Felder, konsistenter gefüllt, häufiger geprüft.
Was dabei entsteht, ist Tagging, das die Richtlinie erfüllt. Ein Pflichtfeld bekommt einen Wert, weil sich der Upload sonst nicht abschliessen lässt. Der Wert stimmt und ist generisch, denn generisch schreibt man, wenn man die Frage nicht kennt.
Dann kommt die Menge. Ein Shooting bringt zweitausend Aufnahmen. Eine Richtlinie, die für zwanzig funktioniert, überlebt zweitausend nicht, und was folgt, ist vorhersehbar. Die Felder werden einmal gefüllt, im Block, mit dem, was für den ganzen Satz gilt. Struktur, die alles beschreibt, beschreibt nichts Bestimmtes.
Metadaten sind eine Vorhersage, keine Beschreibung
Das ist der Teil, den die Richtlinienperspektive verdeckt. Tagging wird meist beschrieben als Festhalten dessen, was ein Asset ist. Das ist es nicht. Es ist eine Wette darauf, was jemand eines Tages fragen wird, abgegeben von einer Person, die die Frage nicht sehen kann.
So gelesen kehren sich die Schlüsse um. Mehr Anstrengung hilft nicht, denn Anstrengung war nie die Begrenzung. Voraussicht war es, und die hat niemand.
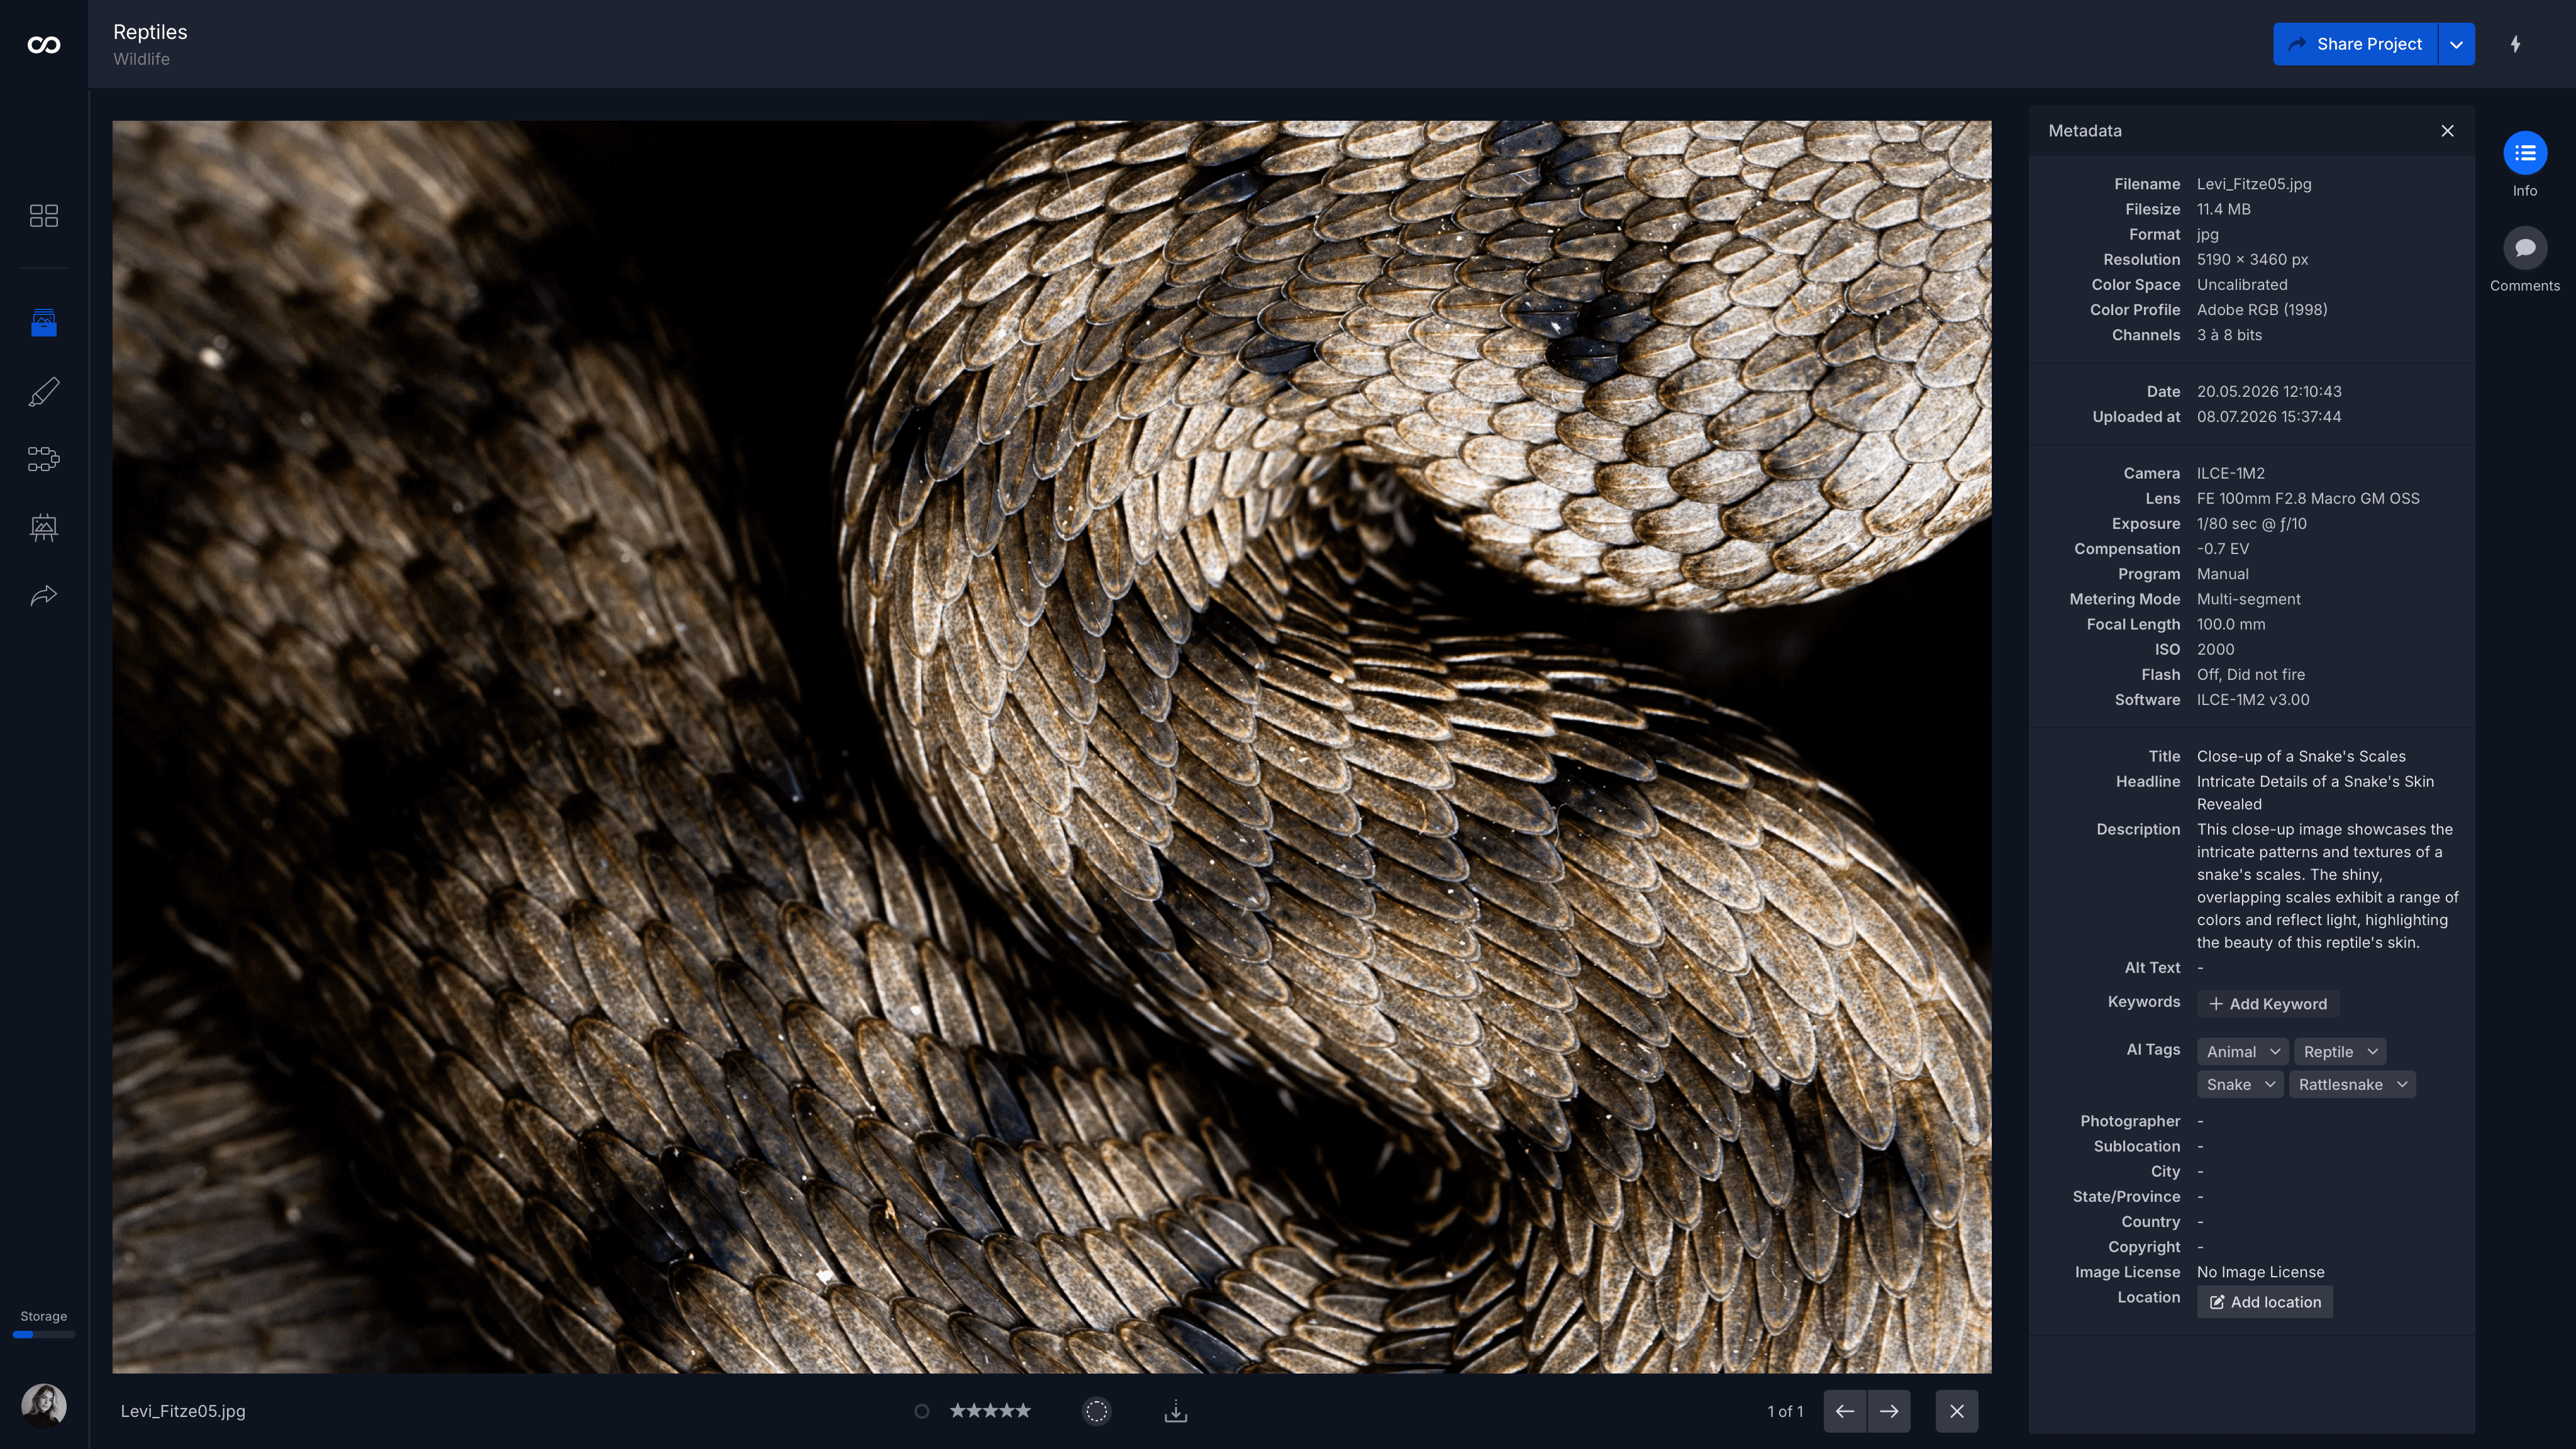
Was überlebt, ist die Struktur, die niemand vorhersagen musste. Tatsachen, die das System auslesen kann, weil sie bereits in der Datei stehen: wann die Aufnahme entstand, mit welcher Kamera und welchem Objektiv, in welcher Form, in welcher Grösse. Und Beschreibung, die aus dem Bild erzeugt statt aus der Erinnerung notiert wird, was den nützlichen Nebeneffekt hat, nicht davon abzuhängen, was der hochladenden Person wichtig erschien.
Das macht menschliches Tagging nicht sinnlos. Es verschiebt es dorthin, wo es wirklich unersetzlich ist: zur Absicht. Eine Maschine kann sagen, dass eine Person auf einem Velo sitzt. Nur wer dabei war, kann sagen, dass die Aufnahme gewählt wurde, weil das Licht vier Minuten lang hielt.
Wo das gilt
Eine Bibliothek, die eine Person füllt und eine Person durchsucht, hat dieses Problem nicht, denn es ist dieselbe Person. Ebenso wenig ein kleiner Bestand, bei dem Durchsehen schneller ist als Suchen. Es zählt bei Menge, über Zeit und über Teams hinweg. Dann ist die hochladende Person weitergezogen, die Kampagne vorbei, und das Asset wird für etwas erwogen, das sich beim Ablegen niemand vorgestellt hat.
Was moodcase damit macht
In den Team-Plänen erzeugt AI Tagging Beschreibung aus dem Bild selbst. So hängt das Wiederfinden nicht daran, was die hochladende Person notiert hat. Asset-Metadaten und Bulk-Bearbeitung gibt es in denselben Plänen, und Global Search durchsucht sie.
Die Aufteilung ist Absicht. Die Maschine übernimmt, was sich ableiten lässt. Der Mensch trägt bei, was sich nicht ableiten lässt, und deshalb bleibt der Tag bearbeitbar statt endgültig.
Wo das hingehört
Das Symptom ist eine Suche, die nichts zurückgibt, und danach jemand, der das Asset findet, indem er sich an die Kampagne erinnert. Das ist kein Wiederfinden. Das ist Gedächtnis, und es geht mit der Person, die es hat.
Visuelle Assets brauchen mehr als einen Ordner. Sehen Sie, wie moodcase den gesamten Workflow abwickelt.
7 Tage testen. Keine Kreditkarte erforderlich.
Metadaten
Suche
Fehlender Kontext
Marketing-Teams
Weitere Artikel

AI Tagging: Was es strukturiert, was es nicht entscheidet.
Wer weiss, was ein Asset ist, wird es nie suchen. Wer es sucht, weiss nichts darüber.

Visual Asset Management ist kein Cloud-Speicher.
Cloud-Speicher sagt, wo eine Datei liegt. Visual Asset Management sagt, was ein Asset ist, was entschieden wurde und wer es nutzen darf.